Une intelligence artificielle omniprésente ne se résume jamais à un modèle accessible par une interface web. Elle repose sur des serveurs, des interfaces de programmation applicative (API), des identités, des bases de données, des outils métiers et des chaînes de déploiement. Les scénarios de coupure d'une intelligence artificielle doivent donc interrompre des capacités précises sans paralyser les activités qui dépendent de son environnement. Une décision trop large bloque les utilisateurs légitimes et peut rendre un incident plus difficile à analyser. Une décision trop étroite laisse subsister des accès, des automatisations ou des copies de données.
Quels scénarios de coupure choisir pour préserver les services essentiels ?
| Situation opérationnelle | Coupure adaptée |
|---|---|
| Réponse dangereuse ou comportement anormal du modèle | Révocation immédiate des clés d'accès et des comptes de service |
| Incident limité à une fonction métier | Isolement de l'application concernée et maintien des autres flux |
| Compromission du fournisseur ou de son API | Basculement vers un modèle de secours ou retour au traitement manuel |
| Risque encore incertain | Dégradation graduelle avec validation humaine renforcée |
Pourquoi une IA omniprésente ne s'arrête-t-elle pas avec un simple interrupteur ?
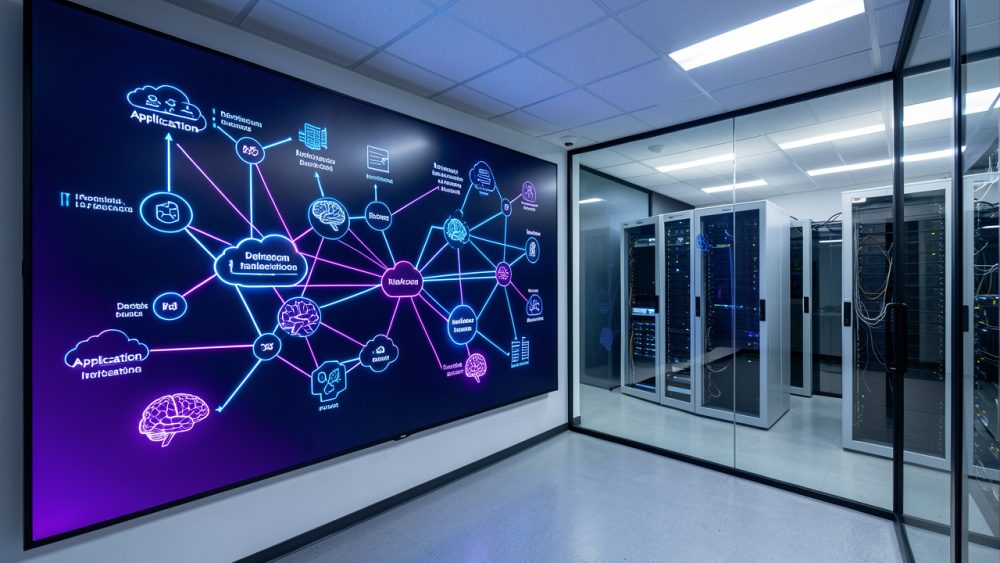
Le modèle n'est qu'un maillon. Une application peut continuer à afficher des réponses mises en cache, à exécuter des tâches planifiées ou à appeler un second service d'inférence. Les dépendances techniques des systèmes IA couvrent aussi les connecteurs documentaires, les fournisseurs d'identité, les journaux d'audit et les entrepôts de données.
Le cas des modèles Fable 5 et Mythos 5 illustre cette dissociation entre disponibilité commerciale et extinction effective. Présentés le 9 juin 2026, ils ont été désactivés le 12 juin au soir, environ trois jours plus tard. Durant cet intervalle, l'opérateur doit savoir si les API, les sorties déjà produites et les intégrations tierces restent utilisables ou doivent être neutralisées.
Une coupure fiable commence par l'inventaire des dépendances techniques critiques. Il faut identifier les points d'appel du modèle, les jetons d'authentification, les files de messages et les services qui consomment ses résultats. Cette cartographie doit inclure les postes locaux et les automatisations hors du périmètre apparent de l'application.
Comment cartographier les dépendances avant un arrêt d'une IA hébergée dans le cloud ?
L'arrêt d'une IA hébergée dans le cloud exige de séparer trois périmètres. Le premier concerne l'accès au modèle et à ses API. Le deuxième regroupe les données envoyées, stockées ou indexées par le service. Le troisième porte sur les processus métiers qui attendent une réponse automatisée.
Chaque dépendance doit avoir un propriétaire, un niveau de criticité et une solution de repli documentée. Une équipe de cybersécurité peut couper une clé API en quelques secondes. En revanche, restaurer un processus de validation humain dans un centre de services demande parfois plusieurs heures et des consignes précises.
Les six domaines les plus exposés à une interruption d'IA générative sont la production logicielle, l'analyse financière, la recherche, la cybersécurité, le service client et la gestion des connaissances internes. Leur point commun est l'intégration du modèle dans des flux répétitifs. Le risque principal vient alors d'une dette opérationnelle invisible, accumulée à mesure que les équipes retirent les contrôles manuels.
La documentation doit aussi prévoir les événements physiques. Une panne de région cloud, une rupture électrique ou un volcan qui perturbe les liaisons réseau peuvent rendre indisponible un site pourtant bien protégé contre les erreurs logicielles.
Quel scénario choisir entre kill switch, isolement et arrêt progressif ?
Un kill switch pour intelligence artificielle doit couper l'inférence, révoquer les identifiants de service et bloquer les nouveaux traitements. Il convient à une exfiltration de données, à un comportement manifestement dangereux ou à une compromission avérée. Son efficacité dépend d'un contrôle centralisé des accès et de tests réguliers.
L'isolement réseau convient lorsque le risque provient d'un connecteur, d'une source documentaire ou d'un agent autonome. L'application reste alors disponible, mais elle ne peut plus consulter la ressource compromise. Cette méthode préserve les fonctions sans accès externe et facilite l'analyse forensique.
Un arrêt progressif et contrôlé est préférable lorsqu'aucun dommage immédiat n'est établi. L'organisation peut réduire les quotas, imposer une validation humaine ou désactiver les actions à effet externe. Elle observe ainsi les conséquences sur les utilisateurs avant de couper les derniers accès.
| Mode d'interruption | Délai d'exécution | Usage pertinent | Limite principale |
|---|---|---|---|
| Révocation des accès | Quelques secondes à quelques minutes | Fuite de clé ou compte compromis | Les tâches déjà lancées peuvent continuer |
| Isolement réseau | Quelques minutes | Connecteur douteux ou agent autonome | Les dépendances internes restent actives |
| Arrêt progressif | Quelques heures à quelques jours | Incertitude sur la gravité | Une exposition résiduelle demeure |
| Arrêt complet du service | Variable selon l'hébergement | Incident critique confirmé | Impact direct sur les métiers |
Qui doit déclencher la gouvernance politique de l'arrêt de l'IA ?
La gouvernance de l'arrêt de l'IA ne peut pas reposer sur une seule personne ni sur une approbation trop lente. L'équipe chargée de l'exploitation doit pouvoir appliquer une mesure technique immédiate. La direction métier, le responsable de la sécurité et le délégué à la protection des données doivent ensuite statuer sur la durée et les conditions de reprise.
Les seuils de décision doivent être écrits avant l'incident. Ils peuvent associer une fuite confirmée à une coupure totale, une baisse de qualité à une suspension limitée et une indisponibilité fournisseur à un basculement. Le journal des décisions doit conserver l'heure, le motif, l'auteur et la portée de chaque action.
Les règles de contrôle humain gagnent à être alignées sur les garde-fous pour l’intelligence artificielle générale en entreprise, afin que l’arrêt ne dépende pas d’une procédure improvisée.
La souveraineté numérique se mesure aussi à cette capacité de décision. Une organisation qui ne maîtrise ni les identités, ni les journaux, ni les copies de données ne possède pas une IA réellement souveraine. Elle dépend alors du calendrier et des interfaces du fournisseur pour limiter un incident.
Comment maintenir l'activité grâce à une architecture multi-modèle ?
Une architecture multi-modèle répartit les usages entre plusieurs services compatibles avec des formats d'entrée et de sortie comparables. Elle réduit la dépendance à un fournisseur unique, mais augmente le travail d'intégration. Les écarts de contexte, de sécurité et de qualité doivent être mesurés avant la crise.
Le basculement vers un modèle de secours ne doit pas être automatique pour les décisions sensibles. Un modèle alternatif peut changer le format d'une réponse, ignorer une consigne métier ou produire des résultats moins fiables. Les fonctions à risque doivent revenir temporairement à un circuit humain ou à des règles déterministes.
La portabilité des données, des prompts et des évaluations constitue une condition pratique de cette stratégie. Les jeux de tests doivent être exportables, versionnés et dépourvus de secrets inutiles. Sans ces éléments, une migration rapide recrée les mêmes erreurs sur une nouvelle plateforme.
Le plan de reprise doit aussi distinguer disponibilité et sécurité. Restaurer vite un accès sans vérifier les autorisations peut réintroduire l'incident. La résilience de l'architecture IT dépend donc autant des procédures de retour arrière que de la redondance technique.
Questions fréquentes sur les scénarios de coupure d'une intelligence artificielle
Un kill switch peut-il arrêter instantanément une IA ?
Un kill switch peut couper l'accès au modèle presque immédiatement si les API et les identités sont centralisées. Il ne supprime pas les réponses déjà enregistrées, les fichiers exportés ou les tâches lancées avant la révocation. Ces éléments exigent des procédures distinctes de purge, d'arrêt de traitement et d'analyse des journaux.
Faut-il couper toute l'IA en cas de cyberattaque ?
Une coupure totale s'impose lorsque l'attaque compromet les identifiants, les données ou le comportement du modèle. Si l'incident touche un connecteur isolé, une segmentation ciblée préserve davantage de services. La décision dépend de la capacité à prouver le périmètre atteint dans les premières minutes.
Comment vérifier qu'un modèle de secours fonctionne vraiment ?
Le modèle de secours doit être testé avec les mêmes jeux d'évaluation que le système principal. Les équipes doivent mesurer la qualité des sorties, les délais et les règles de confidentialité. Un exercice de bascule trimestriel révèle les intégrations oubliées et les permissions périmées.
Quelle est la priorité après l'arrêt d'urgence de l'IA ?
La première priorité est de stabiliser le périmètre, puis de conserver les preuves techniques. Les journaux d'accès, les requêtes envoyées et les versions déployées permettent de comprendre l'origine de l'incident. La reprise intervient après validation des correctifs et confirmation que les comptes compromis sont révoqués.
Un plan de continuité d'activité utile décrit qui coupe, ce qui reste ouvert et comment les équipes travaillent sans IA. Les exercices de coupure transforment cette documentation en capacité réelle. Ils révèlent aussi les dépendances qu'une architecture de production ne montre pas toujours.